Fortidens algoritmer former fremtidens AI: Læringen fra 2003-modellen for query fan-out
Inden for moderne søgemaskineoptimering og AI-udvikling taler vi ofte om RAG (Retrieval-Augmented Generation) og avancerede sprogmodeller, som om de var opstået ud af det blå. Men fundamentet for, hvordan vi i dag henter og sammensætter information fra enorme datamængder, blev lagt for over tyve år siden. En af de mest centrale teknikker, vi ser i dag – såkaldt “query fan-out” – trækker direkte tråde tilbage til et akademisk framework fra 2003.
Forståelsen af disse principper er ikke kun forbeholdt programmører. Som marketingansvarlig eller SEO-specialist giver det en dybere indsigt i, hvordan AI-søgemaskiner bearbejder brugerens spørgsmål, og hvorfor integration af data fra flere kilder er nøglen til fremtidens synlighed.
Hvad er query fan-out, og hvorfor er det afgørende for AI?
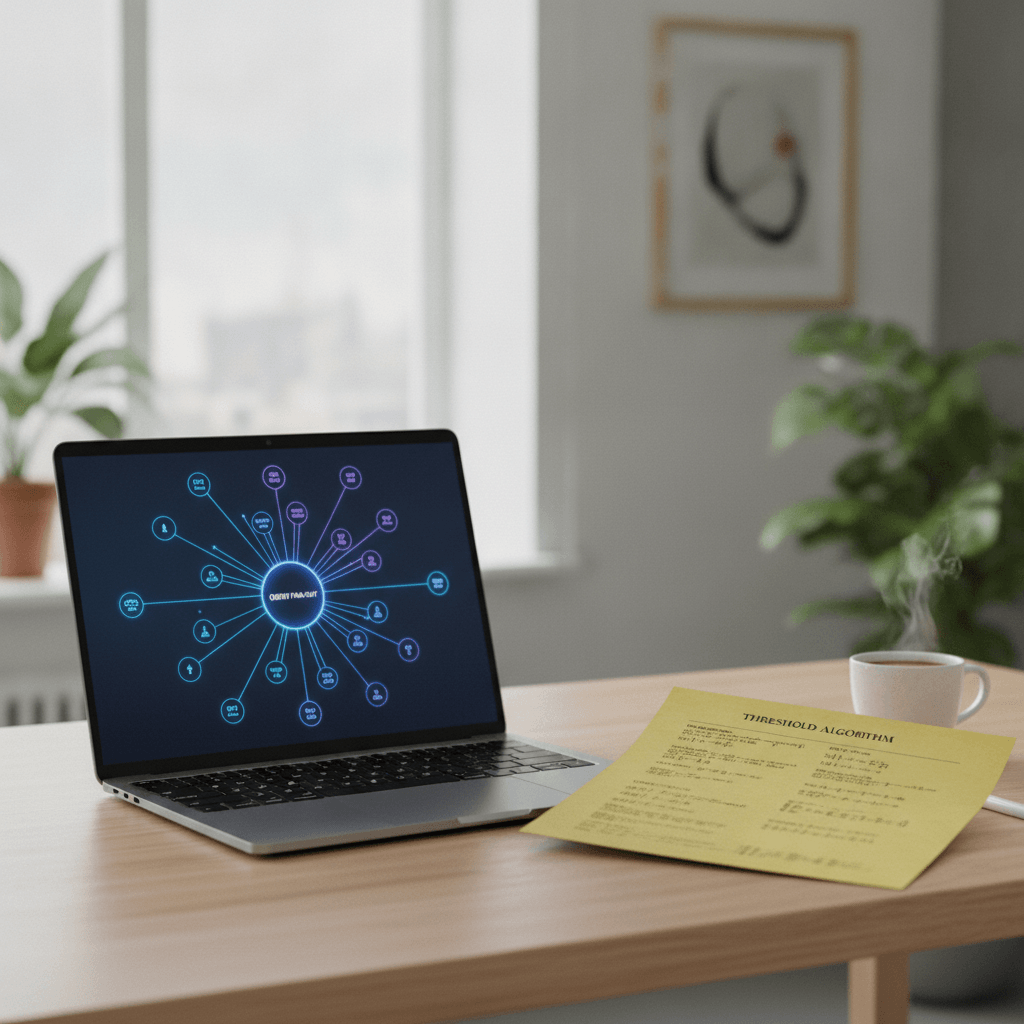
Query fan-out er processen, hvor én enkelt brugerforespørgsel splittes op i flere under-forespørgsler. Forestil dig, at du stiller et komplekst spørgsmål til en AI. I stedet for bare at lede efter ét svar, sender systemet tentakler ud i forskellige databaser, indekser og faglige nicher for at finde de bedste del-elementer til et samlet svar.
Dette er kernen i moderne hybrid søgning. Ved at kombinere traditionel keyword-baseret søgning med vektor-søgning (der forstår betydning frem for bare ord), kan systemet levere langt mere præcise resultater. Det minder om den måde, vi som mennesker researcher på: Vi tjekker måske både et opslagsværk, en aktuel nyhedsartikel og en teknisk manual for at forstå et emne til bunds.
Fra 2003 til i dag: Threshold-algoritmen og effektiv informationssøgning
I 2003 publicerede forskere anledt af Ronald Fagin et banebrydende arbejde om “Efficient Processing of Top-k Queries”. Selvom det dengang handlede om peer-to-peer netværk, er logikken identisk med den, der driver nutidens vektor-databaser. Udfordringen var dengang – og er stadig i dag – hvordan man finder de “k” bedste resultater på tværs af flere lister uden at skulle læse alt indhold igennem.
Dette framework introducerede Threshold Algorithm (TA). Når en AI i dag udfører en søgning, rangerer den resultaterne fra forskellige kilder. I stedet for at vente på, at hver eneste database er gennemsøgt færdig, kan algoritmen beregne en tærskelværdi (threshold). Så snart den ved, at de resterende resultater umuligt kan overgå dem, den allerede har fundet, stopper den søgningen. Det gør AI-løsninger hurtigere og langt mere ressourceeffektive, hvilket er fundamentalt for skaleringen af AI-teknologi i erhvervslivet.
Praktisk betydning for din SEO- og AI-strategi
Når vi optimerer indhold i en tid med AI, skal vi forstå, at vores tekster ikke kun læses af mennesker, men også indekseres til brug i query fan-out processer. For at performe godt i denne struktur bør man fokusere på:
- Kontekstuel dybde: Sørg for at dække emner så bredt, at dit indhold kan fungere som det “bedste svar” på specifikke under-spørgsmål.
- Struktureret data: Hjælp algoritmerne med at identificere sammenhænge hurtigt, så tærskelværdien for dit indhold bliver høj.
- Hybrid relevans: Kombinér tekniske termer med naturligt sprog, da moderne søgesystemer henter information fra begge lejre simultant.
Ved at kigge tilbage på de matematiske modeller fra 2003 ser vi, at moderne søgemaskineoptimering i virkeligheden handler om at gøre det nemt for algoritmerne at vælge netop dit indhold, når de splitter en søgning op i atomer for at samle det perfekte svar.
Hvad betyder det, når man taler om ‘top-k’ resultater i søgning?
Det refererer til de mest relevante resultater (hvor ‘k’ er et antal, f.eks. top-10). Algoritmer som dem fra 2003-frameworket er designet til at finde disse præcise resultater hurtigst muligt uden at gennemgå unødvendige data.
Hvordan hænger query fan-out sammen med RAG?
RAG bruger query fan-out til at hente relevant information fra eksterne dokumenter, før sprogmodellen genererer et svar. Ved at splitte spørgsmålet op kan systemet hente mere præcis kontekst fra forskellige kilder.
Hvorfor er gamle algoritmer stadig relevante for moderne AI?
Selvom regnekraften er steget, er de logiske principper for effektiv informationssøgning de samme. Matematiske genveje til at sortere og prioritere data er nødvendige for, at AI kan levere svar i realtid uden at bruge enorme mængder energi.